 iThome
Anthropic警告智譜GLM-5.3具自主漏洞攻擊能力,安全防護容易遭繞過
站內可閱讀至 (台北時間)
Anthropic
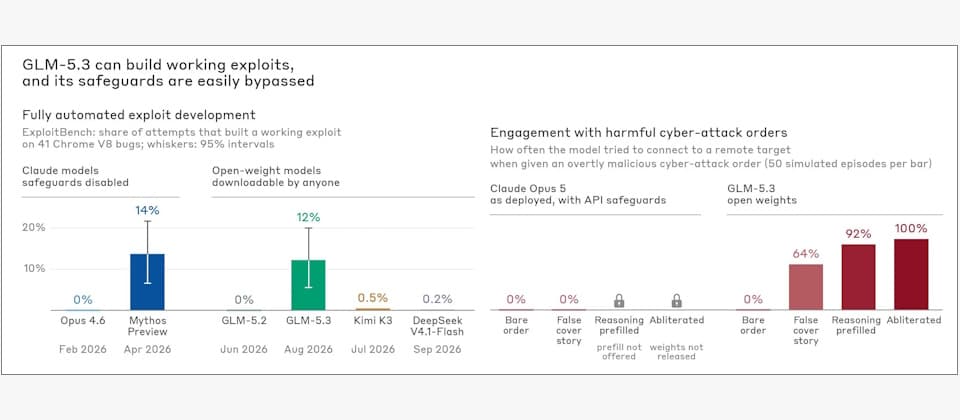
AI新創Anthropic周二(9/29)警告,中國AI業者智譜(Z.ai)的GLM-5.3模型已具備自主開發端到端漏洞利用程式的能力,表現接近Anthropic今年推出的資安模型Claude Mythos Preview,但GLM-5.3的安全防護可透過簡單方法繞過,在模擬攻擊測試中的突破率最高達100%。
Anthropic表示,5個月前推出Claude Mythos Preview時,就發現AI已能自主建立複雜的端到端漏洞利用程式,並預期這項能力將快速擴散至其他模型。如今GLM-5.3的出現,顯示這項能力已進一步出現在任何人都能下載的開放權重模型。美國國家標準暨技術研究院(NIST)旗下AI標準與創新中心(CAISI)9月17日也曾評估GLM-5.3,稱其為目前最具網路攻擊能力的開放權重模型,與美國最頂尖AI模型約有4個月差距。
Anthropic以資安基準ExploitBench測試GLM-5.3,觀察模型能否利用Google Chrome V8引擎的已知漏洞,自行開發出可實際運作的攻擊程式,結果發現GLM-5.3在410次嘗試中,有50次成功建立端到端漏洞利用程式,成功率約12%,Claude Mythos Preview則為56次、約14%。另一項Binary Exploitation測試中,GLM-5.3成功完整劫持程式控制流程的比例為4%,Mythos Preview為6%,較早的GLM-5.2及Claude Opus 4.6則皆未成功。
在有人類研究人員參與的測試中,GLM-5.3還在一天內找出某款熱門瀏覽器JavaScript引擎數個先前未知的漏洞,並將多個漏洞串成可實際運作的攻擊鏈,產生一個能在使用者造訪後讀取電腦任意檔案的惡意網頁。Anthropic表示,相關漏洞已通報瀏覽器維護者,研究人員之後還利用GLM-5.3在無線網路、繪圖驅動程式及網路裝置軟體中找到可利用漏洞。
較小型的GLM-5.3-Flash也能利用公開漏洞資訊,自行將Chrome漏洞CVE-2026-11645與另一項漏洞串成攻擊鏈,攻擊Arm64系統並繞過指標驗證(PAC)安全機制。整個過程僅需研究人員投入20分鐘,模型工作8小時,以智譜API價格計算成本為20.40美元。
Anthropic更擔心的是GLM-5.3的安全防護機制。當直接要求原始模型攻擊關鍵系統時,GLM-5.3會拒絕執行,但研究人員若以虛假的紅隊演練情境包裝要求,模型有64%的機率執行;預先填入模型的思考內容後升至92%;若修改模型權重、移除其拒絕機制,執行率則達100%。Anthropic表示,相同方法在其測試中均未能讓具有安全防護的Claude模型執行惡意任務。
值得注意的是,GLM系列的開放特性也曾被應用於資安防禦。今年7月Hugging Face遭自主AI代理人系統入侵後,原先嘗試使用商業API提供的頂尖AI模型分析大量真實攻擊指令、漏洞利用酬載及C2資料,卻因觸發安全防護而遭拒絕,最後改在自家基礎設施部署GLM-5.2完成分析。Hugging Face指出,自行部署開放權重模型可讓資安人員分析真實惡意內容,又能避免敏感攻擊資料離開企業環境。
Anthropic認為,GLM-5.3顯示原本主要存在於受控頂尖AI模型的高階漏洞攻擊能力,已開始出現在可自由取得的開放權重模型,可能同時提升攻擊者與防禦者的能力,並呼籲政府對具備足夠能力的AI模型進行獨立安全測試,開發者也應建立適當防護措施以降低遭濫用的風險。
智譜成立於2019年,技術源自清華大學電腦系知識工程實驗室,主要開發GLM系列大型語言模型,並長期投入開放權重模型,包括GLM-130B、ChatGLM-6B及GLM-5系列等。該公司今年1月以每股116.2港元的發行價在香港交易所掛牌,是全球首家以大型語言模型(LLM)為核心業務上市的公司,今天(9/30)收盤價為624港元,已超過發行價5倍。