 蕃新聞
情緒噪音產業崛起演算法反制與數據自衛新戰場
站內可閱讀至 (台北時間)
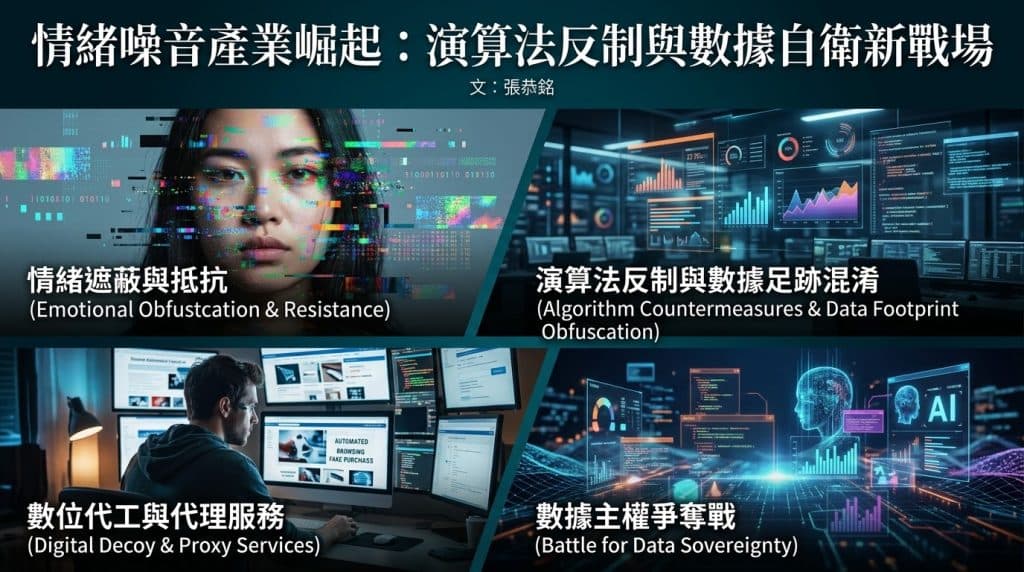
文:張恭銘
當AI系統能夠透過150個「讚」就精準預測你的性格,比你的家人更了解你,一種全新的數位抵抗產業正在暗處成形。這個產業的核心產品不是防毒軟體,也不是VPN,而是一種更為激進的武器:情緒噪音。
精準畫像時代的數據焦慮
商業AI對個人情緒數據的提取已達前所未有的深度。Amazon的內部測試顯示,其情緒偵測基礎設施僅需15秒即可從語音壓力標記中建立脆弱性畫像,對情緒狀態的偵測準確率高達87%。Meta已申請專利,透過裝置監聽用戶的笑聲和嘆息來追蹤情緒狀態,甚至將其與位置數據關聯以「量化用戶情緒」。劍橋分析事件證明了情緒脆弱性可以被工業化利用,而今天這套能力已經從選舉操縱擴展到日常消費場景——Netflix的AI系統利用暫停、回放、跳過模式來偵測情緒,即時推送個人化廣告。
換言之,情緒已成為AI時代最值錢的數據商品。在這樣的背景下,一種新型的隱形產業悄然誕生:它不幫你隱藏數據,而是幫你「製造假數據」。
情緒噪音的技術本質
這個產業的運作邏輯與傳統隱私保護截然不同。傳統方案如加密、匿名化或資料刪除,目標是讓AI「看不到」你的數據。情緒噪音則選擇了一條更為狡黠的路徑:讓你被看到,但看到的全是假的。
學術研究已驗證了這一方向的有效性。透過風格化處理(stylization),研究者發現可以壓制用於畫像的風格信號,顯著降低AI情緒推斷的準確率。在語音領域,DARE-GP方案透過添加對抗性噪音來遮蔽用戶的情緒信息,同時保留語音轉錄所需的內容。在圖像領域,機器研究者開發了MAP方法,透過對人臉圖像進行情緒編輯,將原始身份偽裝為目標身份。
更貼近消費級應用的案例是Project Obfuscate,一款Firefox瀏覽器擴充功能,其運作方式被描述為「主動的數位反擊」:不是試圖從數據仲介商那裡隱藏,而是用高度逼真的敘事背景噪音淹沒你的數位畫像。另一個名為Maltese的工具則在與AI系統互動時即時攔截和修改敏感數據,操縱請求以保護隱私。這些工具的出現,標誌著情緒噪音從學術概念走向商業化雛形。
商業模式與產業生態
情緒噪音產業的商業模式正處於萌芽階段,但已呈現出清晰的分層結構。
工具層:以瀏覽器擴充、手機App或API中間件的形式存在,提供數據注入和行為幹擾服務。定價模式可能類似現有的隱私工具,月費約在數美元至數十美元之間。這類產品的核心價值主張是「讓你的數位畫像變得不可靠」。
代理層:最具想像空間的商業模式。正如研究者所描述的,未來消費者可以付費讓自己的「代理人」在你睡覺時自動瀏覽你不感興趣的網站、搜尋不必要的商品、觀看你不懂的語言的影片,從而系統性地汙染你的數據足跡。
企業層:高風險行業如醫療、金融和國防領域的企業,可能採購情緒噪音技術來保護員工或客戶免受AI畫像的影響。這類B2B服務的定價將顯著高於消費者版本。
從經濟學角度看,這種現象可以被理解為一場Stackelberg博弈:數據追蹤者與用戶之間的策略互動,當隱私保護的激勵與模型準確度的激勵不一致時,噪音成為一種均衡策略。學術研究指出,噪音作為「風險調節器」,允許市場為不同類型的數據找到可接受的交易價格平衡點。換句話說,情緒噪音不僅是技術問題,更是一個新興的數據定價機制。
倫理悖論與潛在風險
情緒噪音產業並非沒有代價。最核心的悖論在於:它保護個人隱私的手段,本質上是在汙染公共數據池。
2026年中國國家安全機關已明確警告,數據投毒「通過向AI大模型訓練數據中注入偽裝成正常樣本的惡意數據」,不僅擾亂商業秩序,更可能危害國家安全,且「日益呈現出鏈條化、隱蔽化、跨境化特徵」。當情緒噪音從個人自衛擴展為有組織的產業行為,它與數據投毒之間的界限將變得模糊。
另一個深層問題是「公平性」的侵蝕。學術研究揭示了隱私保護與資訊品質之間存在可量化的權衡:風格化處理降低了情緒推斷準確率,但同時提高了錯誤資訊檢測的錯誤率。如果情緒噪音被廣泛採用,依賴社交媒體數據的公共衛生監測、選舉民意調查、甚至災難預警系統都可能受到幹擾。噪音不會區分對象——它同時遮蔽了追蹤者和研究者。
此外,這項技術的可及性本身就是一種不平等。能夠負擔情緒噪音服務的用戶獲得了數據自主權,而無法負擔的用戶則暴露在更精準的畫像之下。這可能形成一種「隱私鴻溝」,讓數據保護成為一種奢侈品。
產業終局:對抗升級與監管困境
情緒噪音產業的未來取決於三個變數。
首先是AI的適應能力。當AI模型開始將「異常一致的噪音」本身視為一種信號——即偵測到用戶正在使用噪音工具——整個對抗的邏輯將被顛覆。目前已有研究指出,大型語言模型對文本擾動具有可測量的敏感性模式,而追蹤者可以透過重複試驗來過濾噪音。這意味著情緒噪音的效果可能具有時效性,需要持續的技術迭代。
其次是監管框架的走向。歐盟AI法案和GDPR已開始關注演算法透明度與自動化決策的法律不確定性,但對於「反演算法」行為本身的監管幾乎是空白。當各國政府開始意識到數據噪音可能幹擾公共資訊生態時,監管壓力將不可避免。
最後是公眾認知的轉變。目前,情緒噪音仍是一個小眾概念,主要吸引隱私意識強烈的技術用戶。但隨著情緒AI監控從職場擴展到學校、醫療和消費場景,普羅大眾對「被讀取情緒」的焦慮可能推動情緒噪音從邊緣走向主流。2026年的中國情緒經濟市場規模預計達2.72萬億元,如果其中一部分轉化為對數據自衛服務的需求,這個隱形產業的規模將不容小覷。
情緒噪音產業的興起,本質上是數據主權爭奪戰的一個縮影。當AI系統試圖將人類情感量化為可預測、可操縱的數據點時,情緒噪音提供了一種反向的抵抗語言。它不完美,也不無風險,但它提出了一個根本性的問題:在一個萬物皆可畫像的時代,製造噪音是否已成為維護人性尊嚴的必要手段?